
如何建立銷售招聘評分表
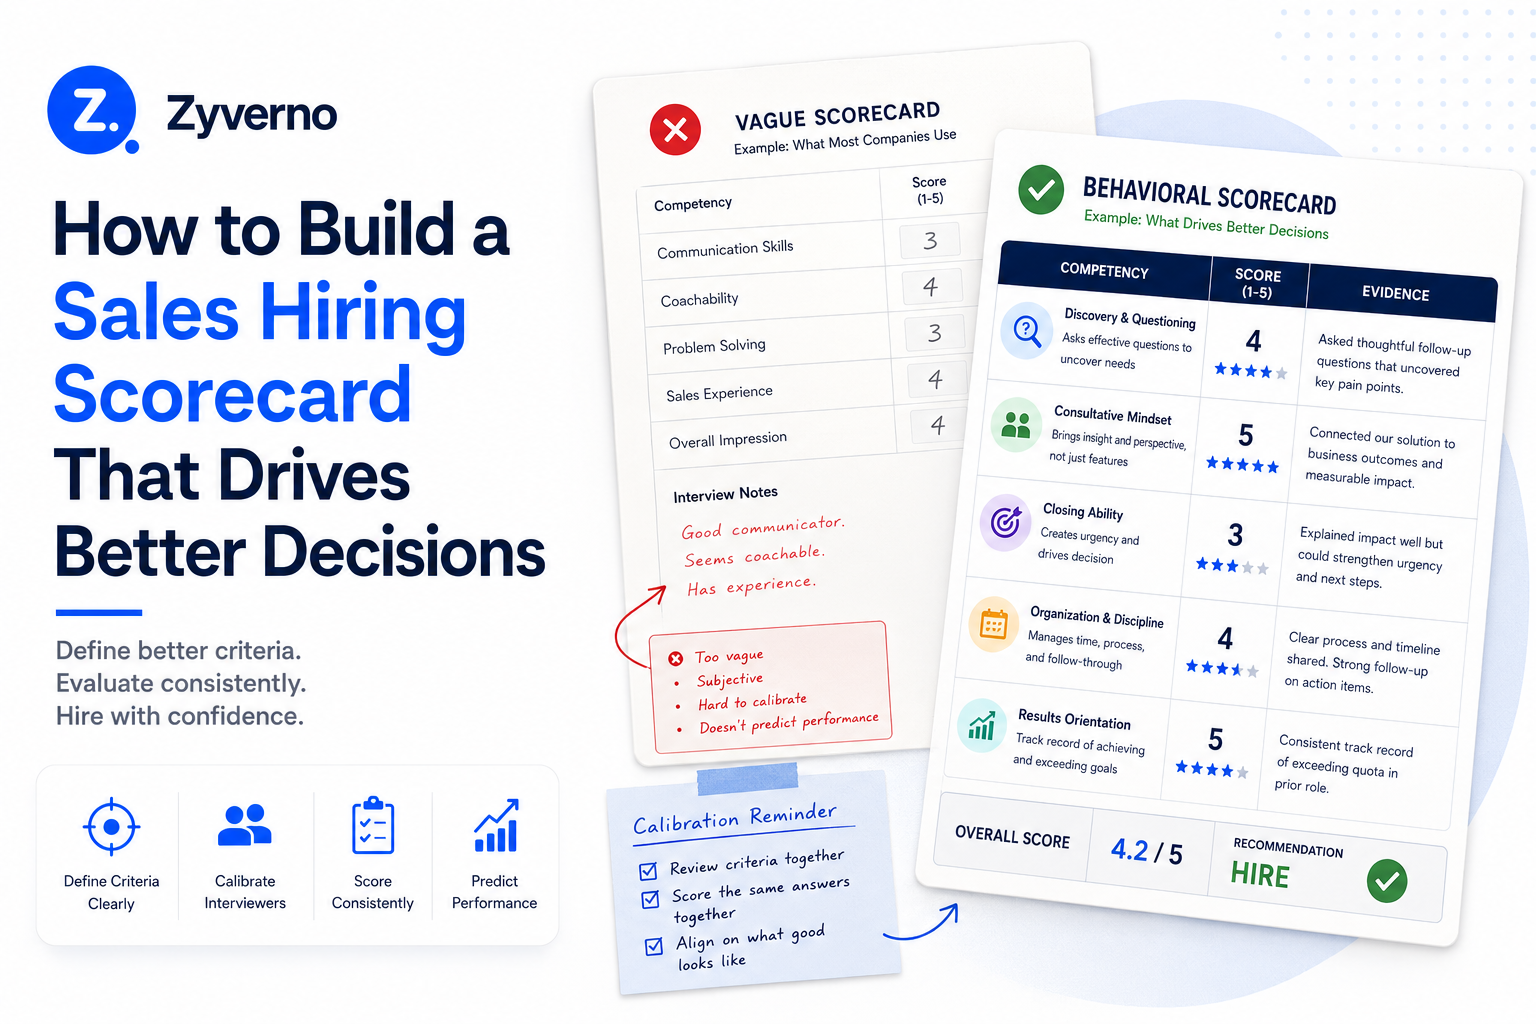
大多數銷售招聘評分表是在做出決定後填寫的。要構建一個實際作為決策工具的評分表:明確地定義能力,在流程開始之前校準面試官關於強與弱的標準,並將評分表的輸出與明確的決策框架聯繫起來。以下是方法。
關鍵要點
- 評分表只有在面試前定義標準時才有效,而不是之後。
- 模糊標準(“溝通技巧”,“可教性”)會產生模糊、無用的分數。具有明確錨定的行為標準會產生可用數據。
- 需要校準。如果兩個面試官對同一答案的評分不同,則標準不夠具體。
- 評分表應該包括一個招聘建議字段和一個決策閾值:如果 X 則雇用,如果 Y 則不雇用,如果 Z 則升級。
- 追踪評分表成績與 6 個月和 12 個月的表現。如果分數與結果無關,則標準是錯誤的。
大多數評分表失敗的原因
在構建一個更好的評分表之前,了解什麼破壞了典型的方法是有幫助的。
模糊標準。 “溝通技巧”在 1 到 5 的評分標準上對面試官而言沒有任何指導意義。兩個面試官可能會分別給同一候選人打 4 分和 2 分,並且都認為他們評估的是同一件事。可觀察到且具體的標準(“針對模糊回答進行了後續提問”與“接受了第一個回答並繼續”)可以產生一致的評分。
Vague Criteria vs. Behavioral Criteria
The difference between a score that means something and one that does not.
沒有錨定描述。 沒有描述一個 3 分是什麼樣子、4 分與2分的區別,3 分的評分毫無意義。沒有行為錨定的情況下,每位面試官都按自己的內部標準進行校準。
沒有決策觸發器。 大多數評分表生成一個分數後,將決策留給“評審的一致意見”。評審變成了一個辯論,擁有最強信念的人勝出,而不是最有力的證據勝出。一個不告訴你如何處理分數的評分表不是一個決策工具。
面試後填寫。 當面試官在評審後而不是面試後立即完成評分表時,討論會污染個人評估。每位面試官的分數會向集體共識偏移,從而消除了多個獨立評估的好處。
根據 Sackett et al. (2022) 在應用心理學期刊 的研究,結構化面試在預測工作表現方面的平均有效性為 0.42,而非結構化面試的平均有效性為 0.16。結構不僅僅是一種管理偏好。它使得評分變得有意義。
有效銷售招聘評分表的結構
第一部分:候選人和角色信息
基本背景使得評分表在幾個月後複查時仍然有用:
- 候選人姓名、日期、面試官
- 正在評估的角色
- 面試階段(招聘人員篩選、招聘經理篩選、技術評估、最終面試環節)
- 此面試官負責評估的能力
如果你的招聘人員篩選階段使用自動預篩選工具,像 Zyverno 這樣的工具會在任何人類篩選之前提供結構化的候選人數據。這些輸出可以在第一階段填充評分表的證據字段,這樣招聘經理可以在審核簡歷時審核評分的響應,而不是一份空白表單。
在多階段面試中,每位面試官應該負責特定的能力,而不是全部。在 45 分鐘的面試中對五個維度進行評估,會使所有五個維度的評分都變得膚淺。兩位面試官各自評估兩個或三個維度則可以產生更深入、更可靠的評估。
第二部分:能力评分
針對該面試官評價的每個能力:
- **能力名稱:**特定的(例如,“管道管理紀律”),而非通用的(“過程導向”)。
- 行為指標: 2 至 3 個可觀察的行為,展示該能力高水平。
- 評分錨: 針對該特定能力的 1、3、5 分的描述。
- 證據字段: 面試官記錄候選人所說或所做的具體事情,以支持該分數,而不是理由,而是實際數據。
示例能力條目:
商業敏銳性(優先級:對客戶執行角色來說很高)
行為指標:
- 用財務或商業影響的術語框定客戶問題,而不是功能術語。
- 在角色扮演或交易演示過程中提問商業結果。
- 能夠用具體數字清晰說明以往交易的投資回報或商業案例。
評分錨:
- 5: 持續詢問商業影響,量化客戶術語的結果,並明確將其解決方案與可測量結果相連接。
- 3: 提出一些商業問題,但在描述價值時退回到產品語言。給出了沒有量化的結果。
- 1: 用產品和功能術語描述所有交易和回應。沒有詢問商業影響。以技術規範語言回答“你的產品做什麼?”
證據(面試官填寫):_______________
分數:___/5
第三部分:具體交易演示評估
對於銷售角色,交易演示是任何面試中最具信息性的部分。它有自己獨立的部分:
- 描述的交易(公司類型、交易規模、週期長度):_______________
- 命名的利益相關者及其角色:_______________
- 遇到的障礙及其應對: _______________
- 具體性評分(1 到 5): 回答有多具體且詳細?
- 5:命名利益相關者,回憶具體的反對意見和回應,回憶時間里程碑,以及推動交易的因素。
- 3:描述了交易類型和一般過程,但對具體時刻和利益相關者的描述較模糊。
- 1:描述了一種交易原型,而不是具體交易。被追問時無法回憶起細節。
- 一致性評分(1 到 5): 故事是否在後續問題中保持一致?
第四部分:溝通質量
每位面試官評分的獨立部分,因為同事與招聘經理的評估方式不同:
- 聆聽: 他們在回答前是否停頓,還是直接插嘴?是否提出澄清問題?
- 簡潔性: 他們是否回答了被問的問題,還是過度解釋?
- 具體性: 他們的例子是具體的還是模糊的?
- 處理不確定性: 當他們不知道某事時,他們是說不知道還是模糊其辭?
在 1 到 5 的評分基礎上附上簡短的證據說明。
第五部分:招聘建議
這是大多數評分表缺失的字段,缺失的原因是評分表最終成為事後理性化工具。
面試官應該進行建議,而不是作為投票,而是作為評估:
- 強烈推薦雇用: 候選人在所需水平上展示了能力。沒有顯著的差距。
- 雇用但存在風險: 在所需水平上展示了大多數能力。具體差距(指出)應在下一階段中探討或在入職期間監控。
- 需要更多信息: 由於時間或對話方向,無法評估(具體能力)。應在(下一階段)中覆蓋。
- 不雇用: 具體能力差距使得此候選人不適合該角色。
關鍵規則:招聘建議必須在評審之前完成,而不是之後。一旦評審開始,建議就會被鎖定。評審後更改分數僅限於添加證據,而不是更改建議。
適應不同銷售角色的評分表
四個核心能力(商業敏銳性、過程紀律、溝通、韌性)適用於銷售角色,但權重和行為指標根據角色變化。
對於銷售開發代表: 更加重視溝通和韌性。此角色需要持續的外向活動和大量的拒絕處理。管道紀律和早期潛在客戶判斷是相關的過程指標,而不是處理複雜性。交易演示部分轉變為“冷外聯演示”。
對於客戶執行人員: 更加重視商業敏銳性和過程紀律。交易演示應探討具體複雜交易。韌性很重要,但差異化信號是候選人是否從商業影響的角度進行思考,並系統管理長期管道流程。
對於銷售經理: 將“商業敏銳性”替換為“輔導和發展方法”。交易演示轉變為“團隊發展演示”:描述一個面臨困難的代表以及你做了什麼。談論他們自己的銷售而不是團隊發展的經理是一種可預見的失敗模式。為他們描述管道評審過程添加一個特定部分。
一個用於所有三個角色的評分表會產生誤導性的分數。即使結構相同,也要構建角色特定的版本。
評分表設計中的偏見保護措施
評分表通過使用行為和具體標準來減少偏見。當標準模糊時,評分表會加大偏見,面試官用主觀印象填充它們。
具體保護措施:
命名行為,而非特徵。 “回答前提出澄清問題”是一種行為。“似乎好奇”是一種印象。行為標準可以在候選人之間一致觀察。基於特徵的標準則被面試官現有的假設所過濾。
要求證據字段。 面試官必須寫下候選人說的或做的具體事情,必須面對他們的分數是基於證據還是感覺。證據要求縮短了分數與理由之間的距離。
將評分與討論分開。 面試官在評審前獨立完成他們的評分和建議。集團討論之後,個人評估會向共識偏移。將它們分開可以保留每位面試官提供的獨立信號。
定期進行不利影響檢查。 如果來自特定人口統計的候選人在特定能力上的評分始終較低,而沒有支持這一模式的績效數據,則標準或校準可能引入系統性偏見。每 6 到 12 個月審查候選人池的匯總數據。
校準:缺失的一步
一個有良好標準但沒有校準的評分表會產生不一致的結果。校準意味著所有輪次的面試官在評估候選人之前就模糊標準的每個評分級別達成一致。
如何校準:
-
在新搜索中第一位候選人之前,進行一個校準會議(30 分鐘),招聘經理描述:
- 每種能力上的 “5” 是什麼樣子,使用以往優秀招聘的例子或假設情境。
- “3” 是什麼樣子,與“好但不出色”相對應。
- “1” 是什麼樣子,是明顯的淘汰者。
-
在前 2 至 3 次面試後,比較面試官之間的分數。如果兩位面試官對同一能力分別打出了 5 分和 2 分,那麼就有校準差距。在下一次面試之前,進行一次簡短的同步來解決這一差距。
-
對於重複角色(持續的銷售開發代表或客戶執行人員招聘),每季度進行校準。隨著你看到真實候選人,心智模型的範圍變得更精確。更新錨定以反映你所學到的內容。
隨時間使用評分表數據
評分表的第二個功能,通常被忽視的是生成數據,幫助你隨著時間的推移改善招聘標準。關於使用數據評估銷售候選人的更廣泛框架,包括哪些預聘評估與績效最強相關,請參閱該指南。
追蹤每位雇員在 6 個月和 12 個月的表現與他們的預聘評分表分數之間的關係。相關性告訴你哪些標準具有預測性:
- 如果“具體交易演示”分數與 12 個月的配額達成率密切相關,則該標準是具有預測性的。賦予其更高的權重。
- 如果“溝通質量”分數與績效沒有相關性,可能是對你的角色沒有預測性,或者你沒有準確測量。修訂或降低優先級。
- 如果標記為“在管道紀律上存在注意風險的雇傭”人員持續表現不足,則該風險標記是真實的。將其視為更嚴格的篩選。
這就是評分表在 12 到 18 個月使用過程中變得更好的方式。第一版本是關於重要內容的假設。經過校準的版本是基於證據的。
有關將評分表數據與更廣泛招聘指標相連接的信息,請參考銷售招聘指標。對於完整的能力模型,評分表應基於 銷售能力框架構建。
模板:一頁銷售招聘評分表
Sales Hiring Scorecard: Visual Template
Rendered version of the one-page scorecard format with behavioral anchors and decision fields
| Competency | Priority | Score (1–5) | Evidence (what they said / did) |
|---|---|---|---|
| Commercial Acumen | High |
|
Interviewer notes here |
| Process Discipline | High |
|
Interviewer notes here |
| Communication & Influence | High |
|
Interviewer notes here |
| Resilience & Self-Management | Medium |
|
Interviewer notes here |
常見問題
銷售招聘評分表應該包含多少個能力?
每個面試階段 3 到 5 個。超過五個會造成評分疲勞和淺層評估。如果你有八個重要標準,將它們分散到兩個面試官之間(每人四個),而不是讓一個人評估全部八個,耗時 45 分鐘。
候選人是否應該看到評分表?
標準,是的。分數和建議,不應該。分享你所評估的內容可以幫助候選人準備相關示例,從而生成更好的信息。如果標準是關於實際能力而非在面試中表現的能力,這並不會給候選人帶來優勢。
如果面試官在評審中顯著分歧怎麼辦?
將其視為數據。顯著分數差異(在同一能力上 2 分或更多)通常意味著標準沒有校準或者面試官出於候選人在每次談話中表現的不同而看到真實的不同之處。第二種情況是有意義的:如果候選人在招聘人員面前表現良好但在招聘經理面前表現不佳,可能表明其在表面溝通方面表現良好而在領域深度方面表現欠佳。
如何為首次招聘的角色構建評分表?
從四個核心能力類別(商業敏銳性、過程紀律、溝通、韌性)開始,並根據角色的要求對其進行加權。在 5 至 8 次招聘後,查看哪些標準與表現相關,哪些沒有。第一個評分表總是個假設。隨著每次招聘,精細化它。
評分表是法律要求嗎?
不是。但它們通過使招聘決策可文檔化並基於標準來減少法律風險。如果候選人聲稱歧視,文檔化的評分表顯示了適用的標準和候選人相對於這些標準的評分,比沒有文檔化的判斷更具抗辯力。關鍵要求:標準必須與工作相關,並在同一角色的所有候選人中一致應用。